New Orleans Alignment Workshop

New Orleans, LA

•

December 10, 2023
December 11, 2023
Date Range
Overview

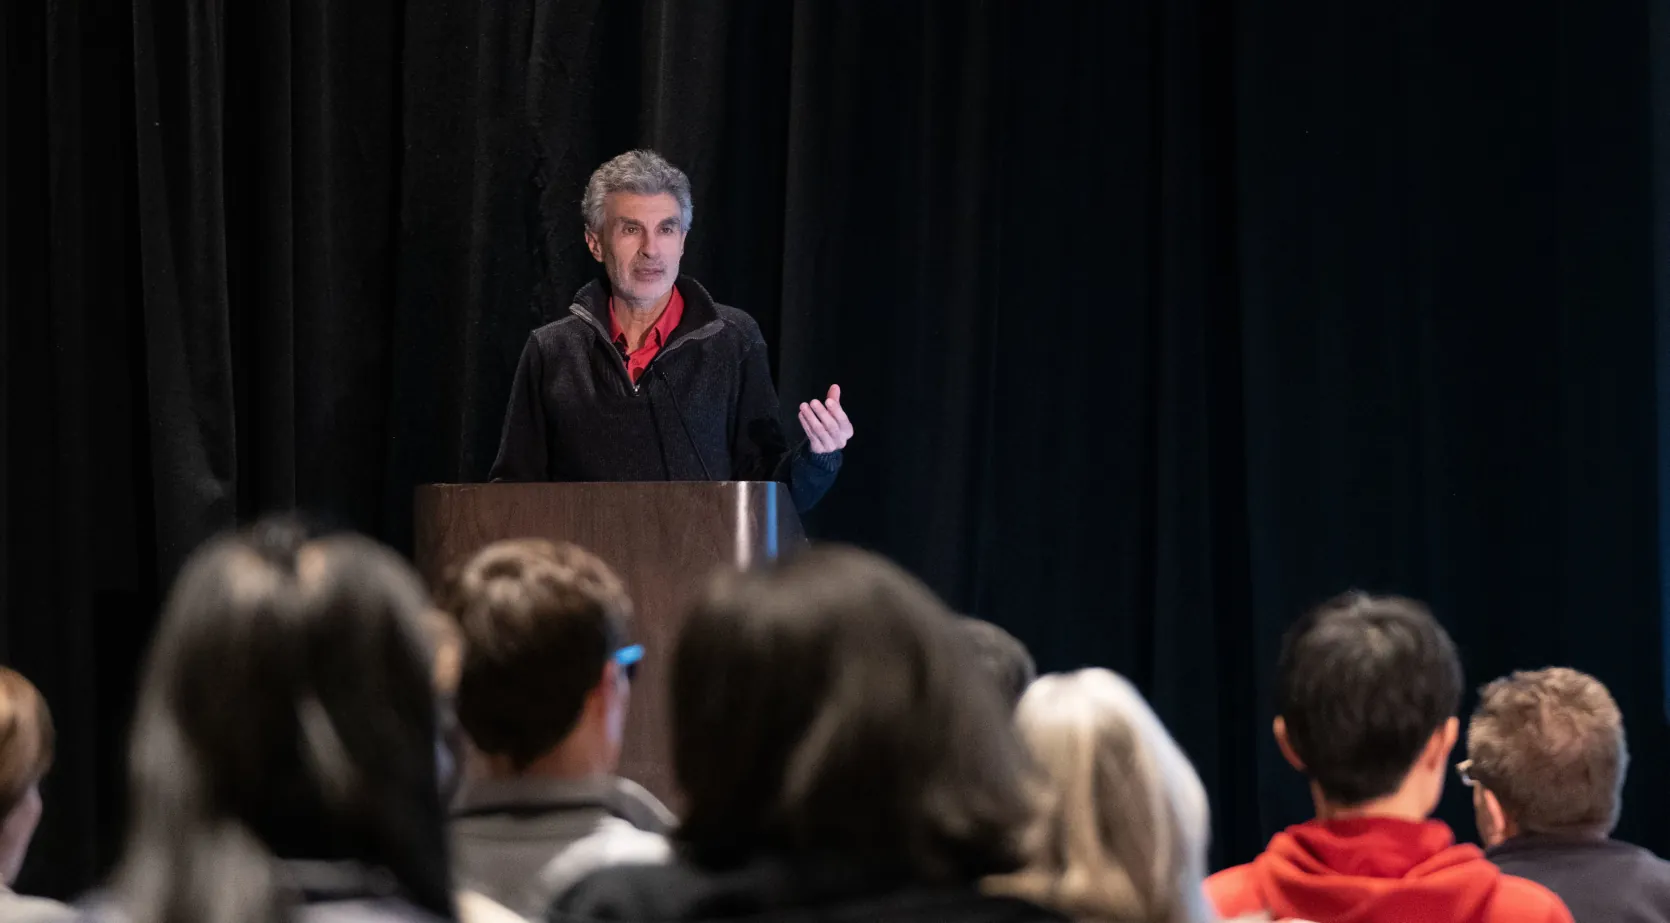
Top ML researchers from industry and academia convened for a second Alignment Workshop in New Orleans in December 2023, just before NeurIPS, to debate and discuss current issues in AI safety, including AI Oversight, Interpretability, Robustness and Generalization, and Governance.

The Alignment Workshop series brings together top machine learning researchers and practitioners from industry, academia, and government. The workshop focuses on discussing and debating critical topics related to AI alignment, enabling participants to better understand potential risks from advanced AI, and strategies for solving them. Key issues discussed include model evaluations, interpretability, robustness, and AI governance.
New Orleans Alignment Workshop sessions

Towards Quantitative Safety Guarantees and Alignment

Yoshua Bengio

•

December 10, 2023

2023

Challenges for AI Safety in Adversarial Settings

Dawn Song

•

December 9, 2023

2023

Your RLHF fine-tuning is Secretly Applying a Regret Preference Model

Brad Knox

•

December 9, 2023

2023

What (and Why) is a Linear Representation?

Victor Veitch

•

December 9, 2023

2023

Weak-to-Strong Generalization

Collin Burns

•

December 9, 2023

2023

Understanding Planning in Neural Networks

Adrià Garriga-Alonso

•

December 9, 2023

2023

Theories and Tools for Mechanistic Interpretability via Causal Abstraction

Atticus Geiger

•

December 9, 2023

2023

The Quantization Model of Neural Scaling

Eric J. Michaud

•

December 9, 2023

2023

The Impossibility of (Strong) Watermarking

Boaz Barak

•

December 9, 2023

2023

The Challenge of Monitoring Covert Interactions and Behavioral Shifts in LLM Agents

Dimitris Papailiopoulos

•

December 9, 2023

2023

System Two Safety

Shane Legg

•

December 9, 2023

2023

Studying LLM Generalization through Influence Functions

Roger Grosse

•

December 9, 2023

2023

Sociotechnical AI safety

David Krueger

•

December 9, 2023

2023

Secret Collusion Among Generative AI Agents

Christian Schroeder de Witt

•

December 9, 2023

2023

Provably Safe AI

Max Tegmark

•

December 9, 2023

2023

Preparedness @ OpenAl

Aleksander Madry

•

December 9, 2023

2023

Preference Learning in Alignment

Dylan Hadfield-Menell

•

December 9, 2023

2023

Out of Context Reasoning in LLMs

Owain Evans

•

December 9, 2023

2023

Optimized Misalignment

Anca Dragan

•

December 9, 2023

2023

Multi-Agent Risks from Advanced AI

Lewis Hammond

•

December 9, 2023

2023

Mechanistic Interpretability of In-Context Learning

Johannes von Oswald

•

December 9, 2023

2023

Keeping Humans in the Loop

John Schulman

•

December 9, 2023

2023

Heuristic Arguments: An Approach to Detecting Anomalous Model

Eric Neyman

•

December 9, 2023

2023

Foundations of Cooperative AI

Vincent Conitzer

•

December 9, 2023

2023

Epistemic Side Effects

Sheila McIlraith

•

December 9, 2023

2023

Emergence of Complex Skills in LLMs

Sanjeev Arora

•

December 9, 2023

2023

Complex Systems View of Large-Scale AI systems

Irina Rish

•

December 9, 2023

2023

Cognitive Dissonance: Why do Language Model Outputs Disagree with Internal Representations of Truthfulness?

Stephen Casper

•

December 9, 2023

2023

Building an Off Switch for AI

Gillian Hadfield

•

December 9, 2023

2023

Alignment and Interpretability: How We Might Get It Right

Been Kim

•

December 9, 2023

2023

Adversarial Scalable Oversight for Truthfulness

Samuel Bowman

•

December 9, 2023

2023

Adversarial Examples Transfer from Machines to Humans

Jascha Sohl-Dickstein

•

December 9, 2023

2023

Adversarial Attacks on Aligned Language Models

Zico Kolter

•

December 9, 2023

2023

AI Safety by Debate via Regret Minimization

Elad Hazan

•

December 9, 2023

2023

AGI Safety: Risks and Research Directions

Adam Gleave

•

December 9, 2023

2023